Explozia modelelor mari de limbaj (Large Language Models – LLM) si adoptarea masiva a aplicatiilor bazate pe Inteligenta Artificiala Generativa au transformat radical cerintele tehnice asupra centrelor de date moderne. In timp ce atentia publica este indreptata aproape exclusiv catre puterea bruta de procesare a acceleratoarelor grafice (GPU-uri) si catre cipurile dedicate, adevaratul erou necunoscut al acestei revolutii tehnologice este infrastructura de retea. Fara o retea extrem de rapida, scalabila si fiabila, cele mai avansate cluster-e de calcul AI ar ramane nefolosite la capacitate maxima, blocate in timpi lungi de asteptare si strangulari de banda. Reteaua din spatele Inteligentei Artificiale nu mai reprezinta o simpla cale de transmisie a datelor, ci a devenit tesatura fundamentala care leaga mii sau zeci de mii de procesoare intr-un singur supercomputer distribuit.
In retelele traditionale de enterprise sau cloud computing, modelul de trafic dominant este de tip nord-sud, adica fluxul de date circula intre utilizatorul final si servere. In schimbarile fundamentale aduse de arhitecturile de Inteligenta Artificiala, modelul de trafic devine masiv de tip est-vest, desfasurandu-se direct intre serverele de calcul si intre GPU-uri. Instruirea unui model LLM modern implica procesarea unor trilioane de parametri si necesita distributia volumelor urias de date intre noduri paralele. Fiecare pas al procesului de antrenare (iteration sau epoch) solicita ca toate GPU-urile implicate sa faca schimb de date de stare si sa isi sincronizeze parametrii in timp real. Daca o singura legatura optica sau un singur port de retea sufera de intarzieri sau pierderi de pachete, intregul cluster de miliarde de dolari este fortat sa incetineasca la viteza celei mai lente conexiuni.
Cerintele critice ale infrastructurii de retea pentru cluster-e GPU
Pentru a satisface aceste cerinte fara precedent, arhitectii de retea au redefinit complet conceptele de topologie si protocoale de comunicatie. Unul dintre pilonii centrali ai retelelor optimizate pentru AI este reducerea drastica a latentei si eliminarea totala a pierderilor de pachete (Zero Packet Loss). In retelele Ethernet clasice, pierderea sporadica a unor pachete de date si retransmiterea lor ulterioara reprezinta un fenomen obisnuit si acceptat. In retelele destinate AI, o singura retransmisie poate cauza fenomene severe de tip “tail latency”, blocand mii de fire de executie paralele si degradand masiv eficienta generala a intregului sistem.
Din acest motiv, tehnologiile de tip RDMA (Remote Direct Memory Access) au devenit obligatorii in arhitectura planului de date. RDMA permite adaptoarelor de retea (NIC-uri) sa transfere date direct din memoria RAM a unui server in memoria altui server sau direct in memoria VRAM a GPU-ului, ocolind complet procesorul central (CPU) si stiva clasica a sistemului de operare. Aceasta abordare reduce latenta de la cateva microsecunde la doar cateva sute de nanosecunde. In prezent, competitia principala se da intre tehnologia proprietara InfiniBand si standardul deschis RoCEv2 (RDMA over Converged Ethernet). Datorita evolutiei rapide a cipurilor de comutare Ethernet de mare densitate si a eforturilor depuse de consortii globale precum Ultra Ethernet Consortium (UEC), RoCEv2 castiga tot mai mult teren, oferind operatorilor o alternativa scalabila, flexibila si interoperabila multi-vendor.
Din punct de vedere al topologiei fizice, retelele clasice de tip Spine-Leaf sunt adaptate in arhitecturi non-blocking de tip Fat-Tree sau Rail-Optimized. In aceste configuratii, numarul de conexiuni inter-switch este calculat matematic astfel incat orice nod sa poata comunica cu orice alt nod la latimea maxima de banda, fara supra-inscriere (oversubscription 1:1). Topologiile “rail-optimized” grupeaza porturile GPU-urilor pe sine dedicate de interconectare, reducand numarul de hibrizi si switch-uri prin care trebuie sa treaca datele in timpul etapelor critice de sincronizare colectiva de tip AllReduce.
Tehnologiile optice de Terabit: De la 800G la 1.6T si arhitecturile LPO si CPO
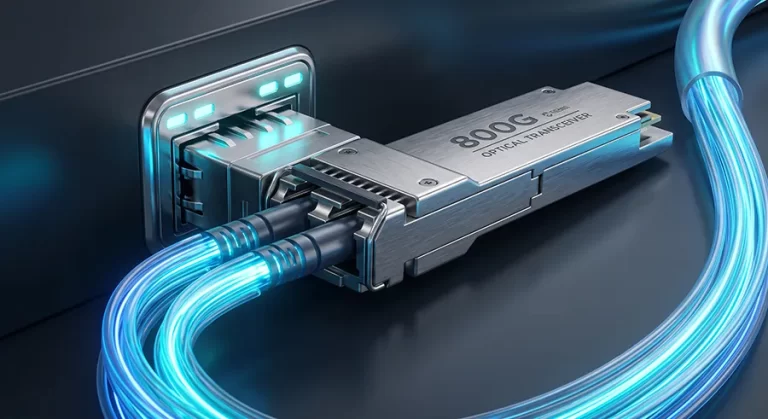
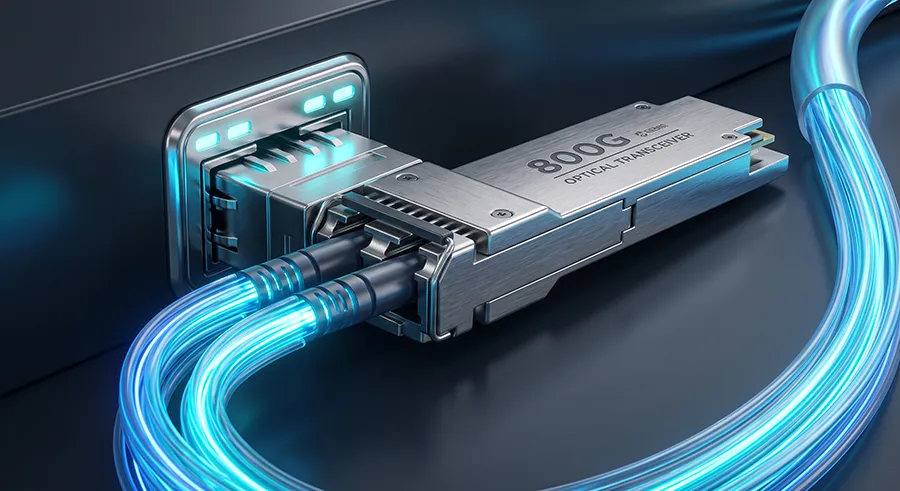
Nivelul fizic al retelei AI este locul unde inovatia optica avanseaza in cel mai rapid ritm din ultimul deceniu. Densitatea uimitoare de porturi necesara in switch-urile AI moderne (bazate pe cipuri de comutare de 51.2 Tbps si 102.4 Tbps) a fortat tranzitia rapida de la legaturile traditionale de 100G si 400G catre transceivere optice de 800Gbps si 1.6T. In prezent, modulele optice in formate OSFP si QSFP-DD de 800G reprezinta standardul de baza in construirea noilor clustere de calcul AI de mare viteza.
Aceste viteze astronomice de transmisie sunt posibile datorita modulatiei de semnal PAM4 (Pulse Amplitude Modulation 4-Level), care codifica doi biti de informatie pe fiecare simbol optic, dubland capacitatea canalului comparativ cu modulatia traditionala NRZ. In plus, cipurile avansate DSP (Digital Signal Processor) integrate in interiorul fiecarui modul optic curata, amplifica si corecteaza erorile de semnal la viteze de peste 100 Gbps pe cale optica (lane). Totusi, utilizarea DSP-urilor genereaza o provocare majora: un consum ridicat de energie electrica si o cantitate mare de caldura disipata in panourile frontale ale switch-urilor.
Pentru a adresa aceasta problema energetica, industria si organismele de standardizare precum OIF (Optical Internetworking Forum) exploreaza solutii inovatoare precum LPO (Linear-drive Pluggable Optics) si CPO (Co-Packaged Optics). LPO elimina complet cipul DSP din interiorul modulului optic, bazandu-se pe capabilitatile avansate de egalizare ale ASIC-ului din switch. Rezultatul este o reducere substantiala a consumului de energie cu pana la 50% per port si o reducere critica a latentei, parametru vital pentru retelele AI. Pe de alta parte, tehnologia CPO muta motoarele optice direct pe acelasi substrat de siliciu cu cipurile de comutare sau cu acceleratoarele AI, eliminand traseele lungi de cupru de pe placa de baza si deschizand drumul catre o noua era a arhitecturilor optice de scala Terabit.
Eficienta energetica, racirea lichida si provocarile din infrastructura de retea
Proiectarea centrelor de date destinate Inteligentei Artificiale a redefinit complet parametrii de alimentare electrica si de racire. Un singur rack complet populat cu servere de calcul si acceleratoare AI poate depasi un consum de 40 kW pana la peste 100 kW per rack, cifre imposibil de gestionat cu metodele clasice de racire pe baza de aer. Caldura generata nu provine doar de la procesoarele grafice, ci si de la densitatea uriasa de transceivere optice compacte instalate pe panourile switch-urilor.
In acest context, gestionarea termica a devenit un factor decisiv in mentinerea stabilitatii retelei. Modulele optice moderne sunt echipate cu radiatoare metalice avansate si sunt concepute pentru a rezista la temperaturi de operare ridicate fara a suferi degradari ale laserelor interne. In paralel, centrele de date AI adopta pe scara larga tehnologiile de racire lichida (Liquid Cooling, Direct-to-Chip sau Immersion Cooling). Aceasta tranzitie influenteaza direct modul in care sunt proiectate cablurile de fibra optica, conectorii multifibra de mare densitate (cum sunt MPO-16, MPO-24 si SN/MDC) si transceiverele, impunand standarde si mai stricte de etanseitate, toleranta mecanica si fiabilitate.
Importanta parteneriatelor tehnice in era infrastructurii AI
In concluzie, succesul si viteza de dezvoltare ale Inteligentei Artificiale depind in mod direct de evolutia retelei subiacente. Fara o infrastructura optica de terabiti, fara protocoale de retea Zero-Loss si fara o strategie riguroasa de gestionare a latentei si a consumului de energie, cele mai avansate cipuri AI nu isi pot atinge potentialul maxim. Reteaua din spatele AI este o capodopera de inginerie care combina optica de inalta precizie, siliciul de comutare extrem de performant si topologii matematice complexe intr-un organism digital unitar.
Pentru companiile care construiesc, extind sau modernizeaza retele de centre de date si infrastructuri de transmisie de date, alegerea componentelor optice corecte si intelegerea standardelor din industrie reprezinta cheia unei investitii sigure si durabile. Pentru mai multe analize tehnice, ghiduri si noutati din domeniul opticii de mare viteza si al retelisticii, va invitam sa urmariti si celelalte articole de pe pagina noastra de blog: https://startbit.ro/blog-posts/ . De asemenea, echipa noastra de specialisti va sta la dispozitie cu consultanta tehnica, transceivere optice certificate si solutii profesionale de interconectare adaptate noilor cerinte de terabiti. Va invitam sa ne contactati pentru a discuta cerintele proiectului dumneavoastra accesand pagina noastra de contact: https://startbit.ro/contact/ . Impreuna putem construi o retea pregatita pentru provocarile erei AI.